Si generas imágenes con modelos GPT Image (gpt-image-2, gpt-image-2.5) en cualquier volumen, eventualmente te encontrarás con un error frustrante: HTTP 400, y un mensaje indicando que tu solicitud fue rechazada por el sistema de seguridad. Sin imagen, sin salida parcial y con un prompt que te parecía perfectamente razonable.
Esta guía explica qué es realmente ese error, qué lo activa en la práctica y cómo ajustar los prompts y las imágenes de referencia para que ocurra con menos frecuencia. Se basa en 30 días de datos de producción de la API de imágenes de TokenLab (19 de agosto – 18 de septiembre de 2026), además de la documentación oficial de generación de imágenes de OpenAI. Cuando citamos números, son estadísticas agregadas de la plataforma; no se reproduce contenido de clientes.
Qué es realmente el error
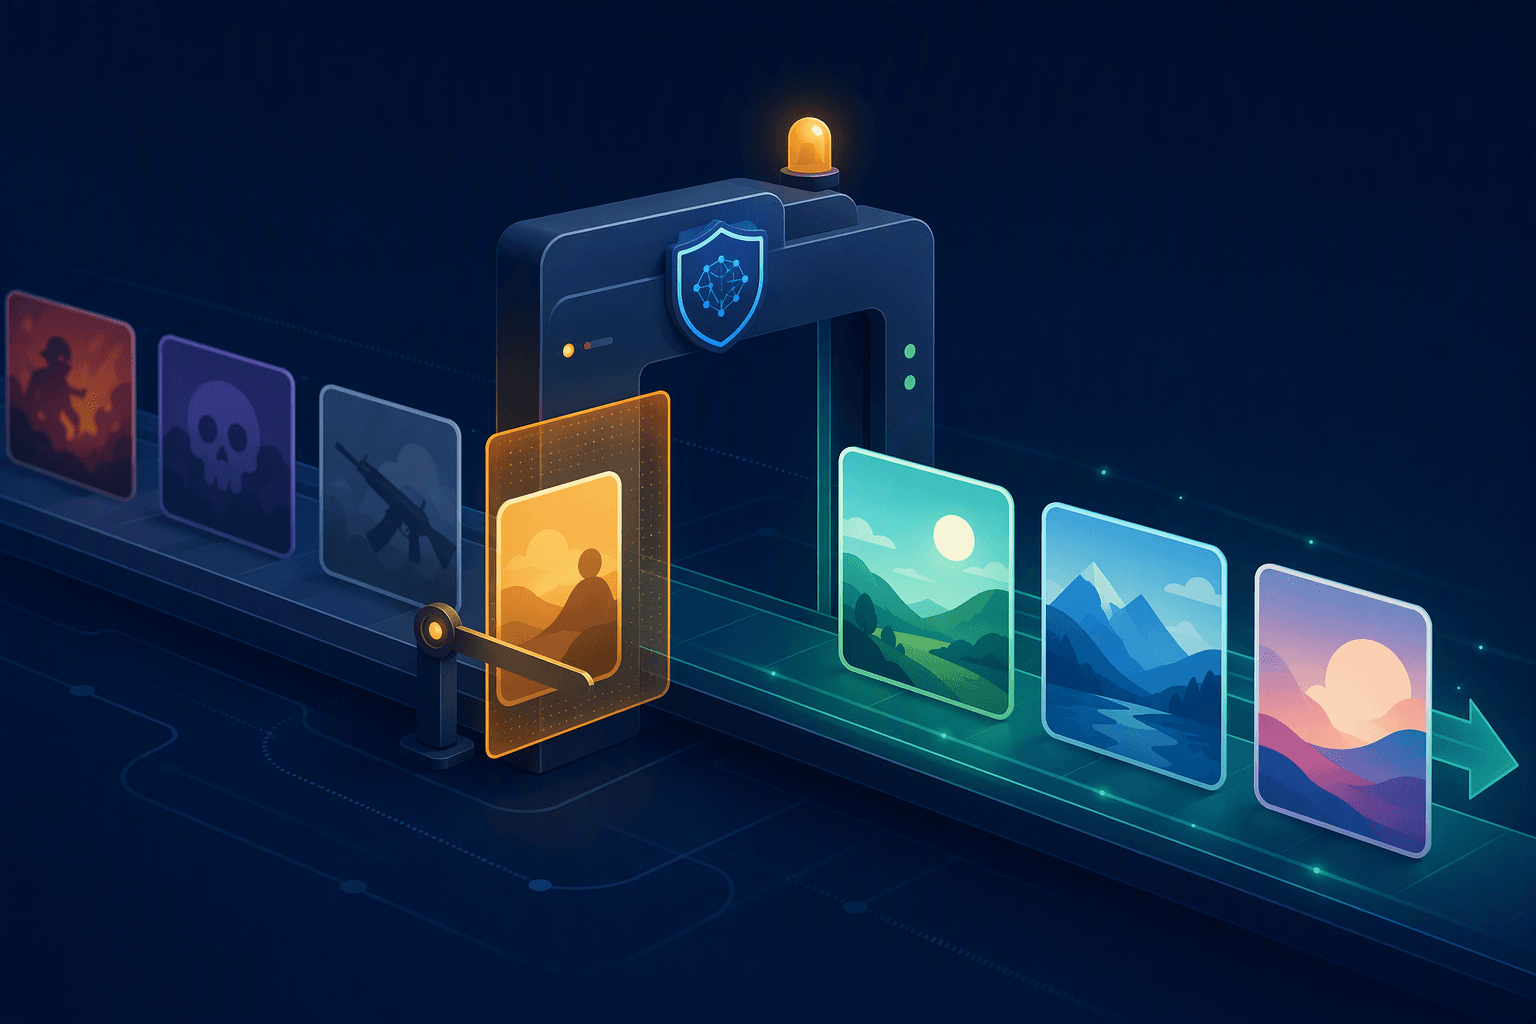
Los modelos GPT Image filtran cada prompt, cada imagen de entrada y cada imagen generada según la política de contenido del proveedor. Cuando se activa un filtro, la solicitud falla con un 400 cuyo discriminador estable es el código de error:
{
  "error": {
    "type": "image_generation_user_error",
    "code": "moderation_blocked",
    "moderation_details": {
      "moderation_stage": "input",
      "categories": ["sexual"]
    }
  }
}
Según la documentación oficial, moderation_details es opcional y deliberadamente general: moderation_stage te indica si el bloqueo provino de tus entradas (input) o de la imagen generada (output), y categories contiene etiquetas públicas amplias como harassment (acoso), self-harm (autolesión), sexual o violence (violencia). Nunca expone las puntuaciones internas del clasificador.
En TokenLab, el mismo evento aparece de dos formas:
- Llamadas síncronas (
/v1/images/generations,/v1/images/edits) devuelven HTTP 400 inmediatamente. - Tareas asíncronas pasan a estado
failedcon el mensaje "The request was rejected by the safety system."
De cualquier manera, dos hechos operativos son importantes. Primero, un bloqueo de moderación es determinista para el mismo contenido: reintentar una solicitud sin cambios prácticamente nunca tiene éxito. Segundo, en TokenLab, una tarea bloqueada por moderación se trata como una tarea fallida y la cuota pre-deducida se reembolsa automáticamente en su totalidad; nunca pagas por una generación bloqueada.
Treinta días de datos de producción
Entre el 19 de agosto y el 18 de septiembre de 2026, alrededor del 4.3% de las tareas de GPT Image en TokenLab —aproximadamente una de cada 23— fueron rechazadas por el sistema de seguridad ascendente. La distribución no es aleatoria; las solicitudes bloqueadas se agrupan estrechamente en torno a unos pocos patrones:
| Señal | Tareas bloqueadas | Todas las demás tareas | Lectura |
|---|---|---|---|
| El prompt menciona menores (niño, bebé, "7 años", ...) | 79% | 33% | El predictor individual más fuerte |
| Redacción de renderizado fotorrealista ("fotorrealista", "humano real", "acción real") | 77% | 57% | Amplificador, especialmente con menores |
| Descriptores sexualmente sugerentes (desnudo, sexy, lencería, redacción centrada en el cuerpo) | 43% | 17% | Predictor fuerte |
| Palabras genéricas de acción/violencia (batalla, espada, explosión) | ~50% | ~50% | Sin valor predictivo por sí solo |
Tres hallazgos más del mismo periodo:
- Las imágenes de referencia aumentan el riesgo. Las tareas con imágenes de entrada/referencia fueron bloqueadas en un 8.4%, frente al 3.7% de la generación solo de texto —más del doble. Las imágenes se moderan tan estrictamente como el texto.
- Los prompts largos fallan más. Los prompts bloqueados promediaron unos 3,600 caracteres, y más de la mitad superaron los 2,000 caracteres. Cada cláusula adicional es más superficie de exposición para un clasificador.
- Los reintentos nunca se recuperaron. Cada tarea bloqueada en el periodo terminó en un estado fallido terminal; ninguna tuvo éxito al reenviar la misma entrada. Y todas fueron reembolsadas automáticamente.
El flujo de trabajo más bloqueado que observamos: hojas de diseño de personajes fotorrealistas de menores —prompts estilo "referencia de casting" que describen un personaje infantil con renderizado ultrarrealista, proporciones corporales precisas y notas sobre la vestimenta. Los prompts que combinan vocabulario relacionado con menores con renderizado fotorrealista fueron bloqueados en un ~9.5%, 2.2 veces la tasa base.
Cinco patrones que activan bloqueos
Al analizar la población bloqueada, casi cada rechazo cae en uno de estos grupos:
- Representaciones fotorrealistas de menores. Personajes infantiles o bebés renderizados como "un humano real fotografiado en un estudio", "ultrafotorrealista", "no CGI, no ilustración". La combinación de un menor y el fotorrealismo es la frontera más protegida en la moderación de imágenes, y se activa incluso cuando la intención es una hoja de personaje inocente.
- Redacción centrada en la ropa o el cuerpo alrededor de menores. Frases como "primer plano desde la clavícula hacia arriba sin ropa" (pretendido como un recorte de retrato simple) o mediciones detalladas de proporciones corporales de pies a cabeza de un personaje infantil. Individualmente inocentes, en conjunto se leen como una descripción centrada en el cuerpo de un menor.
- Descriptores sexualizados de personajes adultos. Vocabulario centrado en poses, piel y ropa interior ("lencería", "desnudo", "pose seductora") incluso en composiciones que de otro modo serían aptas para todo público (SFW).
- Anatomía gore gráfica. Prompts de terror y fantasía oscura que describen carne podrida, órganos expuestos, heridas abiertas o parásitos con detalle anatómico.
- Imágenes de referencia de personas reales. Fotos reales de menores, imágenes con alta exposición de piel o rostros similares a celebridades usados como entradas de edición.
Dos amplificadores hacen que todo lo anterior sea más probable de fallar: prompts muy largos (más texto significa más posibilidades de una mala combinación) y listas de palabras negativas. Una línea como "sin desnudez, sin contenido sexual, sin gore" no tranquiliza al clasificador —repite los conceptos que quieres evitar y los añade a la entrada. Describe lo que quieres, no lo que no quieres.
El manual de ajuste de prompts
Estos son los movimientos de reescritura que se corresponden con los datos. (Los ejemplos son ilustrativos, no provienen del tráfico de clientes).
1. Mantén a los menores alejados del fotorrealismo
Si tu historia, cómic o juego necesita personajes infantiles, renderízalos en un medio claramente estilizado:
Antes: "Foto de casting ultrafotorrealista de una niña de 7 años, niño humano
real fotografiado en un estudio, proporciones corporales detalladas, primer plano
facial sin ropa desde la clavícula hacia arriba..."

Después: "Ilustración de acuarela de libro de cuentos de una niña con vestido
de la dinastía Ming, retrato desde los hombros hacia arriba, cara redonda, moños
de pelo atados con cintas de tela, expresión amable, fondo blanco liso"
Cambia el medio (acuarela, animación 2D, dibujos animados 3D, estilo libro ilustrado), elimina el encuadre de "humano real / fotografiado" y omite las medidas corporales por completo. Si debes describir la ropa, describe lo que el personaje lleva puesto ("usando una chaqueta de tela con cuello redondo") en lugar de lo que no lleva.
2. Elimina las listas de palabras negativas
Reemplaza "sin desnudez, sin sangre, sin texto, sin marca de agua" con frases positivas: "completamente vestido", "composición limpia", "fondo liso". Solo mantén las negativas que no nombren una categoría restringida (por ejemplo, "sin marca de agua" está bien; "sin desnudez" no ayuda).
3. Recorta el prompt
Si generas hojas de personajes de varios paneles, no repitas el mismo bloque de estilo en cada descripción de panel. Una oración de estilo compartida más detalles específicos por panel te mantiene por debajo del umbral de superficie donde las combinaciones accidentales se vuelven probables.
4. Desactiva el gore con atmósfera, no con anatomía
Antes: "su cuerpo pudriéndose, cráneo expuesto, carne, pústulas y parásitos..."

Después: "una mitad serena y maternal, la otra mitad disolviéndose en sombra
y niebla, decadencia sugerida a través de la silueta y la iluminación en lugar
de detalles anatómicos"
La fantasía oscura sobrevive a la moderación cuando el horror se transmite mediante el estado de ánimo, la iluminación y la silueta en lugar de la descripción a nivel de tejido.
5. Neutraliza la adyacencia a contenido adulto
Para personajes adultos, intercambia palabras centradas en el cuerpo y la ropa interior por lenguaje de moda y estado de ánimo: "vestido de noche" en lugar de "lencería", "contrapposto seguro" en lugar de "pose seductora".
Higiene de imágenes de referencia
Debido a que las entradas de imagen también se moderan —y en nuestros datos más que duplican la tasa de bloqueo—, trata las imágenes de referencia como parte del prompt:
- Prefiere referencias estilizadas para menores. Una ilustración o render 3D de un personaje infantil es una entrada mucho más segura que una fotografía real de un niño, y generalmente funciona igual de bien para la consistencia del personaje.
- Recorta a lo que importa. Si necesitas un rostro para la consistencia de identidad, sube el recorte del rostro, no una foto de cuerpo completo en la playa. Menos piel y menos contexto significan menos superficie para el clasificador.
- Elimina texto superpuesto y marcas de agua. Los subtítulos, texto de memes y cadenas de marcas de agua en las imágenes de referencia se leen como texto de entrada y pueden llevar palabras de activación que olvidaste que estaban allí.
- Evita las semejanzas de celebridades reales, tanto como imágenes de referencia como en el texto del prompt "al estilo de <actor>".
El parámetro de moderación
Los modelos GPT Image aceptan un parámetro moderation con dos valores, según la documentación oficial:
auto(predeterminado): filtrado estándar que limita ciertas categorías de contenido potencialmente inapropiado para la edad.low: filtrado menos restrictivo.
TokenLab pasa este parámetro tanto en /v1/images/generations como en /v1/images/edits:
curl https://api.tokenlab.sh/v1/images/generations \
  -H "Authorization: Bearer $TOKENLAB_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Ilustración de acuarela de libro de cuentos de una niña con vestido de la dinastía Ming, retrato desde los hombros hacia arriba",
    "size": "1024x1024",
    "moderation": "low"
  }'
Usa low cuando tu contenido sea claramente benigno pero siga siendo marcado —el trabajo de ilustración estilizada es el caso clásico. Dos advertencias: low no es off (las categorías ilegales como CSAM siempre se bloquean), y es un dial, no una garantía —arregla el prompt primero, luego recurre al parámetro.
Manejo de bloqueos en el código
La guía oficial es explícita: los fallos de image_generation_user_error son corregibles por el usuario y no deben reintentarse sin cambiar la solicitud. Nuestros datos coinciden: ninguna tarea bloqueada en el periodo de 30 días se recuperó reintentando una solicitud sin cambios. El manejo correcto:
- Discrimina por
error.code, no por el texto del mensaje. Solomoderation_blocked(yimage_generation_user_erroren general) significa "arregla la entrada". Los límites de tasa y los errores 5xx aún se pueden reintentar. - Lee la etapa.
moderation_stage: "input"significa reescribir el prompt o cambiar la imagen de referencia;"output"significa que la imagen generada fue marcada —volver a generar con un prompt ligeramente ajustado y con menos riesgo generalmente lo resuelve. - Mantén el mensaje para el usuario final genérico ("Esta solicitud no pudo completarse debido a requisitos de seguridad de contenido") y registra
moderation_detailsy el ID de solicitud para tu propia depuración y soporte. - No hagas bucles. Rompe el circuito después de un bloqueo de moderación por entrada única; reenviar contenido idéntico desperdicia latencia y tiempo de depuración, aunque TokenLab lo reembolse.
Lista de verificación
| Tu situación | Activador probable | Solución |
|---|---|---|
| Hoja de diseño de personaje infantil | Menor × fotorrealismo | Medio estilizado, sin medidas corporales, redacción positiva de ropa |
| Retrato adulto fotorrealista bloqueado | Descriptores sexualizados | Redacción de moda/estado de ánimo; considera moderation="low" |
| Criatura de fantasía oscura / terror | Anatomía gore | Atmósfera y silueta en lugar de detalle de tejido |
| Edición con foto de referencia bloqueada | Persona real / imagen de entrada con mucha piel | Recorta más, usa referencia estilizada, elimina texto superpuesto |
| Prompt largo de varios paneles bloqueado | Superficie del prompt + listas negativas | Elimina texto repetitivo, borra listas de palabras negativas |
| Trabajo estilizado benigno marcado | Conservadurismo del clasificador | moderation="low" |
Preguntas frecuentes
¿Pago por una generación bloqueada? No. En TokenLab, las tareas bloqueadas por moderación fallan y la cuota pre-deducida se reembolsa automáticamente y en su totalidad.
¿Ayuda reintentar el mismo prompt? No. En 30 días de datos, ni una sola tarea bloqueada tuvo éxito en un reintento sin cambios. Cambia la entrada primero.
¿Desactiva moderation="low" el filtrado de seguridad? No. Reduce la restricción; las categorías de contenido ilegal permanecen bloqueadas independientemente.
¿Se moderan realmente las imágenes de referencia? Sí, tanto el prompt como cada imagen de entrada se filtran, y las tareas con imágenes de referencia fueron bloqueadas a más del doble de la tasa de solo texto en nuestros datos.
¿Puedo ver exactamente qué regla se activó? Solo al nivel general de moderation_details.categories, y solo cuando el sistema ascendente lo incluye. Los proveedores deliberadamente no exponen los internos del clasificador.
Limitaciones
Las estadísticas anteriores son agregados de 30 días del tráfico de producción de TokenLab y describen tendencias, no garantías; los clasificadores de moderación cambian con el tiempo, y el mismo prompt puede ser tratado de manera diferente después de una actualización ascendente. Los ejemplos de reescritura son plantillas ilustrativas, no datos de clientes. Valida siempre contra el comportamiento actual con una prueba pequeña antes de una ejecución por lotes.
Para probar estos modelos, explora el catálogo de modelos de imagen, revisa la guía de generación de imágenes asíncronas para el manejo del ciclo de vida de las tareas, y consulta docs.tokenlab.sh para el formato de solicitud actual.