Die TokenLab Console fühlte sich für uns nicht mehr wie ein Dashboard an, als der Coding-Assistant-Modus und der KI-Applikations-Modus zu einer einzigen Arbeitsoberfläche verschmolzen wurden. In unserer Pipeline befinden sich die Anfrage, die Antwort und der dazugehörige Kontostatus nun an einem Ort. Das spart bei jeder Sitzung einen Kontextwechsel und verändert die Art und Weise, wie wir eine langsame Antwort lesen.
Die wichtigsten Erkenntnisse
- Der Coding-Assistant-Modus und der KI-Applikations-Modus befinden sich jetzt beide in der TokenLab Console; die zwei älteren Einstiegspunkte wurden darin zusammengeführt.
- Bestehende Links funktionieren weiterhin und frühere Konversationen sind noch vorhanden. Es muss nichts manuell migriert werden.
- Antworten werden gestreamt, während das Modell sie generiert, anstatt erst am Ende zu erscheinen. Die Oberfläche zeigt das Timing des ersten Tokens an.
- Die Latenz bis zum ersten Token ist ein aufgezeichnetes Anfragesignal (
ttft_msim Anfrageprotokoll) und keine reine Dekoration der Benutzeroberfläche. - Wenn das Guthaben mitten in einer Konversation zur Neige geht, befindet sich der Auflade-Button direkt neben der Konversation und nicht auf einer separaten Abrechnungsseite.
- Die Modellauswahl der Konsole folgt dem öffentlichen Katalog; prüfen Sie das Modellverzeichnis für aktuelle Optionen. Aktuelle Katalogbeispiele umfassen Claude Sonnet 5 und DeepSeek V4 Pro.
Was sich in der TokenLab Console geändert hat und was nicht
Die Änderung wurde in zwei Changelog-Einträgen veröffentlicht. Die Konsolen-Konvergenz (2026-08-04) führte die zwei älteren Einstiegspunkte in einer Konsole zusammen. Das Konsolen-Chat-Streaming (2026-08-18) fügte dem Chat Streaming hinzu. Die beiden Änderungen erfolgten im Abstand von einem Monat, sodass Teams, die den ersten Eintrag verpasst haben, den zweiten automatisch erhalten.
Dies ist eine Änderung der Oberfläche, keine Verhaltensänderung. Modellaufrufe, Keys und Abrechnung sind unverändert. Alte Links funktionieren weiterhin und bestehende Konversationen wurden bei der Zusammenführung beibehalten. Es gibt keinen manuellen Migrationsschritt.
Der Konvergenzschritt betrifft die Einstiegspunkte, nicht den Modellzugriff. Der Streaming-Schritt betrifft die Art und Weise, wie eine Antwort erscheint, nicht welche Tokens abgerechnet werden. Das ist wichtig, weil eine Änderung der Produktoberfläche eine Verhaltensänderung verbergen könnte, was hier jedoch nicht der Fall war. Da sich der Coding-Assistant-Modus und der KI-Applikations-Modus nun einen Ort teilen, ist die erste Entscheidung in einer Sitzung nicht mehr, welchen Einstiegspunkt man öffnen soll.
Wenn Ihr Team Runbooks hat, die auf die alten Einstiegspunkte verweisen, aktualisieren Sie die Bezeichnungen, wenn Sie dazu kommen. Die alten Links funktionieren weiterhin, das Runbook wird also nicht unterbrochen. Die Konsole ist der Ort, den Sie für neue Arbeiten als Lesezeichen speichern sollten. Wenn Sie in einem der Modi ein Modell auswählen, folgt die Wahl dem öffentlichen Katalog; prüfen Sie also das Modellverzeichnis. Aktuelle Katalogbeispiele umfassen Claude Sonnet 5 und DeepSeek V4 Pro.
Streaming in der TokenLab Console verändert das Lesen einer Sitzung
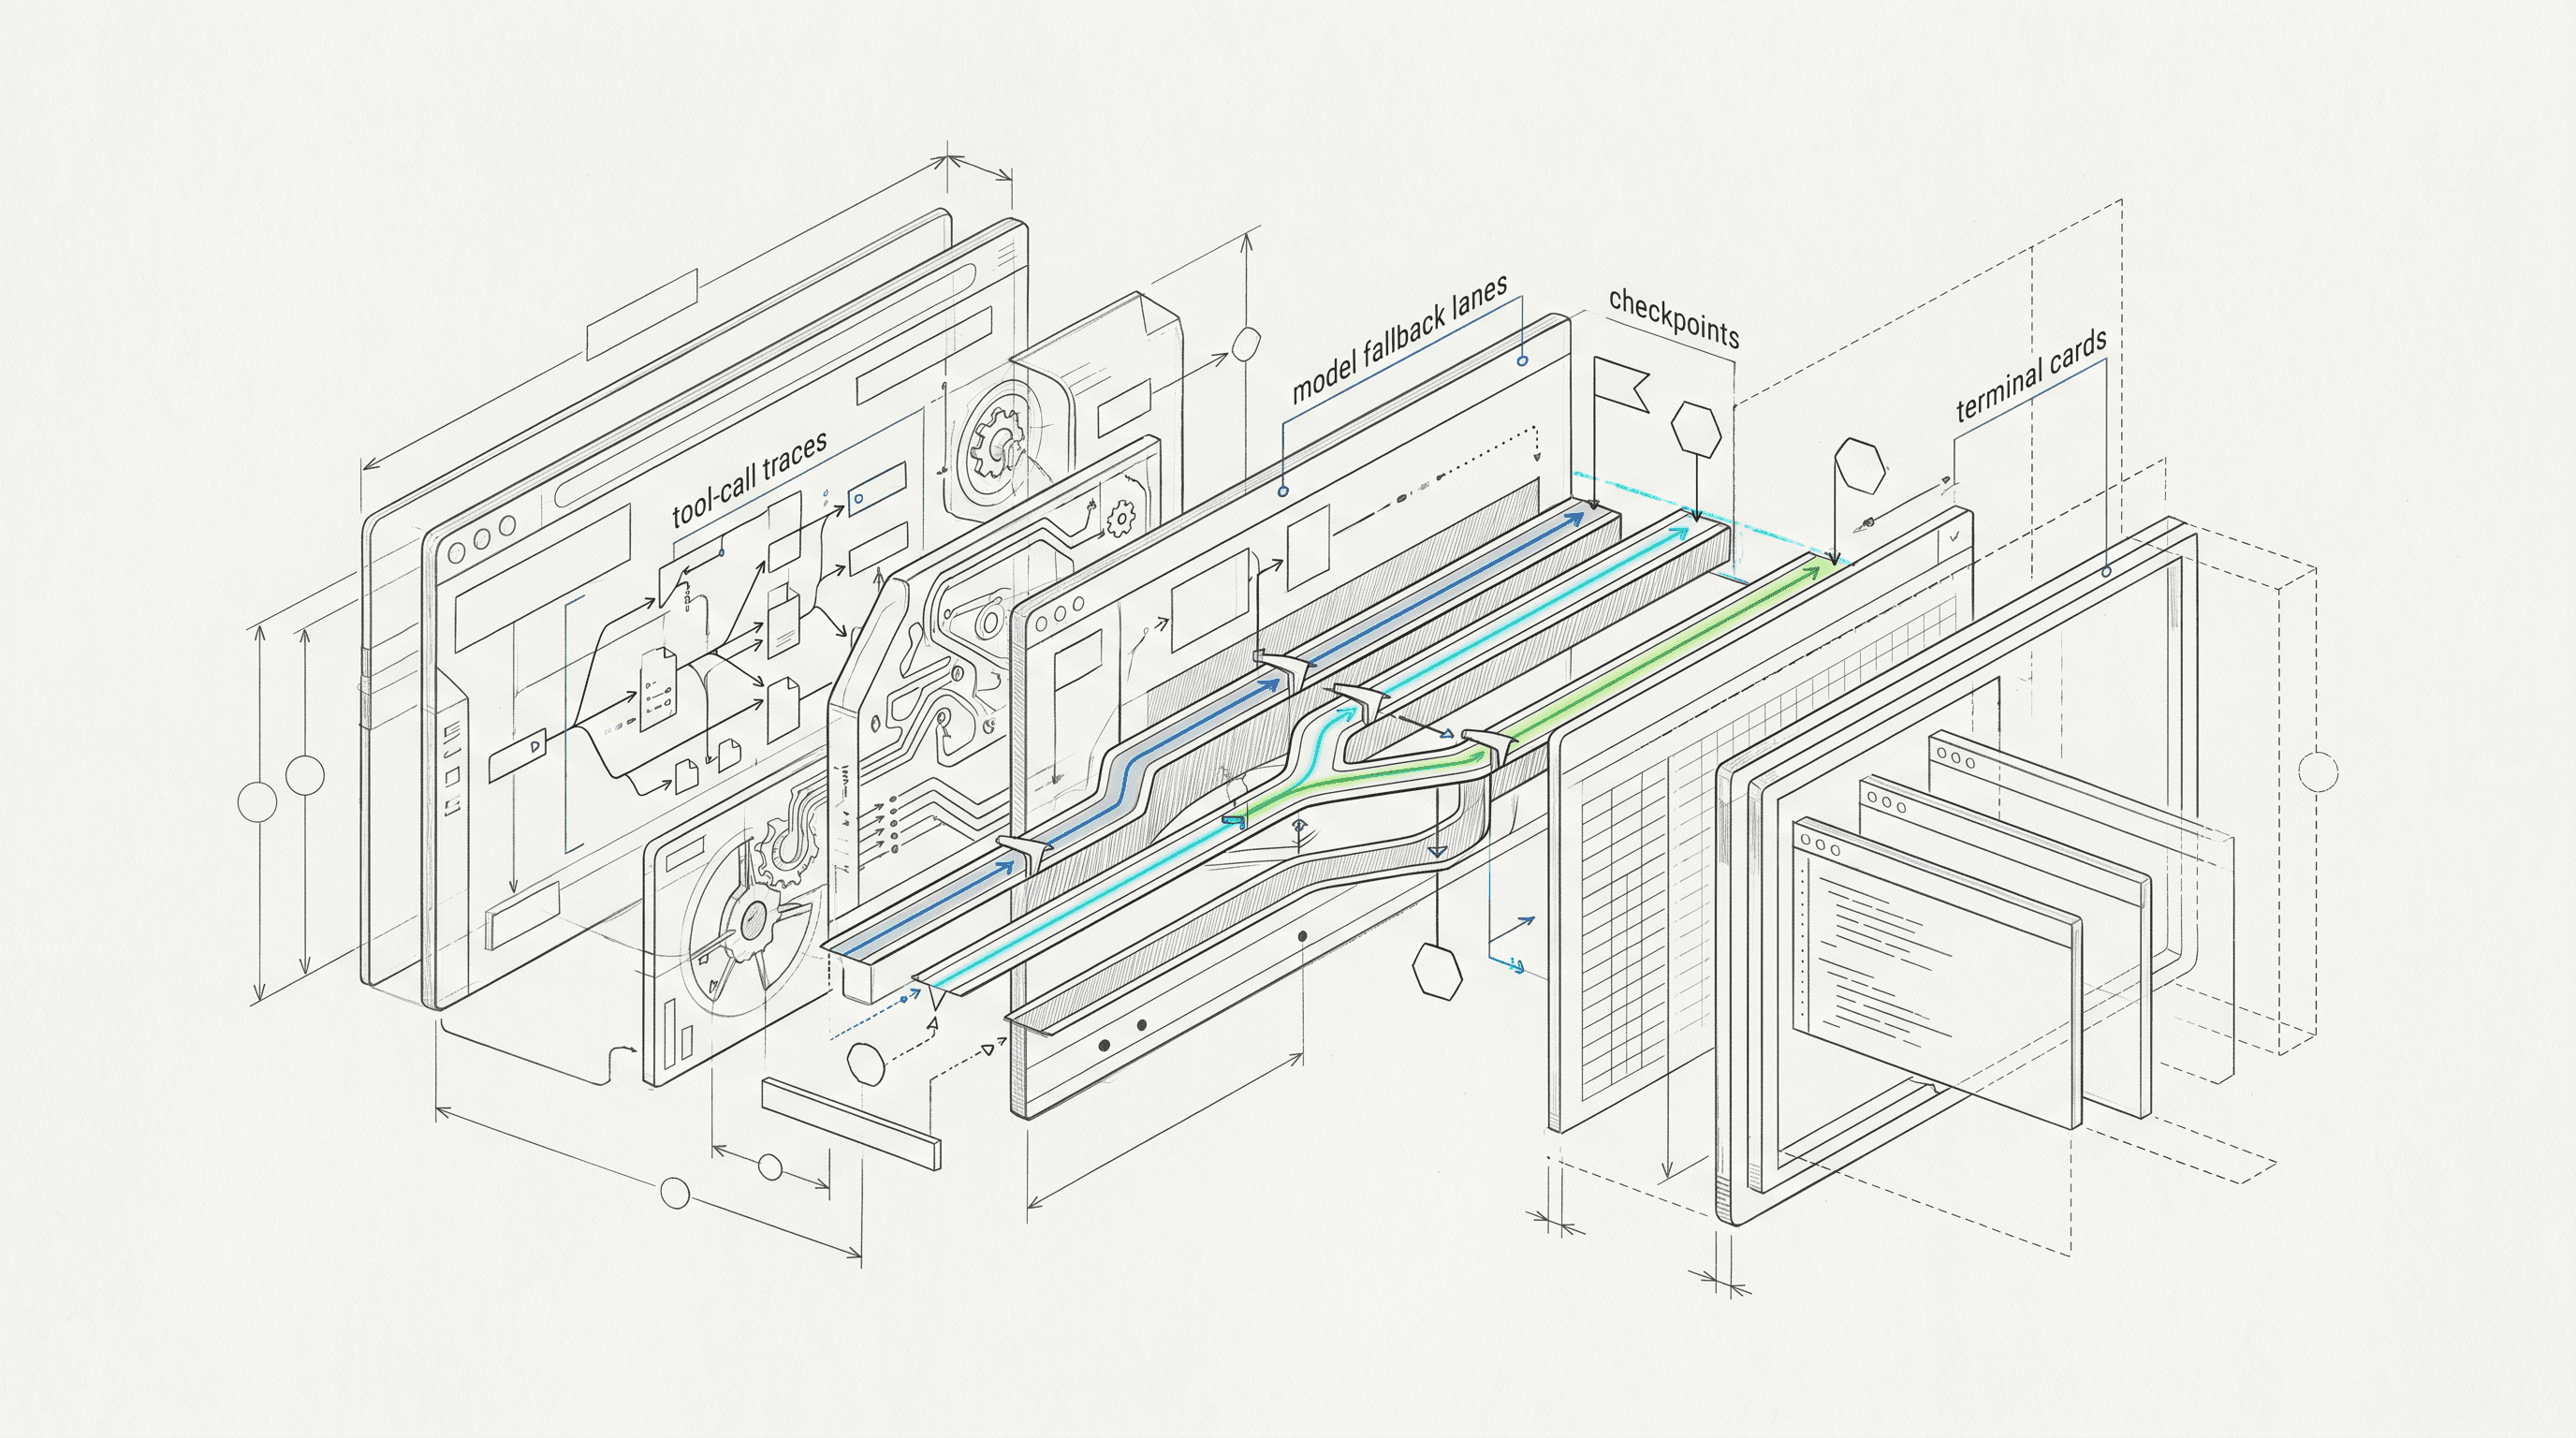
Streaming verändert den Moment, in dem Sie wissen, dass etwas passiert. In unserer Pipeline erstellt der Console-Gateway-Client Streaming-Chat-Anfragen und die Antwort wird inkrementell gerendert. Die Schnittstelle zeigt das Timing des ersten Tokens an, sodass Sie sehen können, wann das Modell beginnt zu antworten. Die Konsole zeichnet dieses Signal auch als ttft_ms auf, eine optionale Spalte im Anfrageprotokoll.
Das Timing des ersten Tokens sagt Ihnen, wann das erste Token eingetroffen ist, während die Gesamtlatenz angibt, wann die gesamte Antwort abgeschlossen war. Das sind unterschiedliche Fragen. Wenn sich eine Antwort also langsam anfühlt, prüfen Sie zuerst ttft_ms. Wenn das erste Token spät eintrifft, liegt die Wartezeit vor der Generierung. Wenn das erste Token früh eintrifft und die Antwort sich hinzieht, liegt die Wartezeit im Rest des Streams.
Wenn wir eine langsame Sitzung beobachten, vergleichen wir ttft_ms mit den restlichen Anfragedaten, anstatt vom Spinner zu raten. Die Beweise auf Anfrageebene sind auf die Organisation beschränkt und decken Routing, Abrechnungsstatus, Cache-Status sowie den Modell- und Key-Kontext hinter einer Anfrage ab. Die Konsole stellt denselben Anfragedatensatz bereit, den Sie sonst aus den Protokollen herausfiltern müssten.
Ein praktisches Beispiel für das Lesen des First-Token-Signals:
# Das Konsolen-Anfrageprotokoll stellt `ttft_ms` als optionale Spalte bereit.
# 1. Filtern Sie das Anfrageprotokoll auf die Anfrage, die Sie prüfen.
# 2. Lesen Sie `ttft_ms`.
# 3. Vergleichen Sie `ttft_ms` mit der Gesamtlatenz der Anfrage in derselben Zeile.
Für die genaue Form der Streaming-Anfrage verwenden Sie die aktuelle TokenLab API-Dokumentation. Ein kopiertes Anfragebeispiel mit erfundenen Feldern wäre weniger nützlich als die Dokumentationsseite, zu der diese Namen gehören.
Streaming ändert nichts an der Abrechnung, da dieselben Tokens produziert werden, aber sie sind sichtbar, sobald sie eintreffen. Da Antworten jetzt gestreamt werden, zeigt eine unterbrochene Sitzung immer noch die teilweise Antwort anstelle von gar nichts. Das ändert die Art und Weise, wie Sie einen Fehler während der Sitzung diagnostizieren. Für lang laufende Jobs, die nicht durch einen Chat-Stream abgedeckt sind, lesen Sie den Leitfaden für asynchrone Bildgenerierungsaufgaben.
Wie man eine langsame Sitzung überprüft, ohne zu raten
Beginnen Sie mit dem Anfrageprotokoll, nicht mit dem Spinner, da die Spalte ttft_ms Ihnen sagt, wann das erste Token eingetroffen ist. Wenn diese Zahl hoch ist, hatte das Modell noch nicht begonnen zu antworten. Wenn diese Zahl niedrig ist, hat das Modell früh begonnen und der restliche Stream hat die Zeit in Anspruch genommen. Diese Aufteilung verhindert, dass Sie den falschen Teil des Pfades beschuldigen.
Der Anfragedatensatz ist auf Ihre Organisation beschränkt. Er enthält die Route, die die Anfrage bedient hat, den Abrechnungsstatus, den Cache-Status sowie den Modell- und Key-Kontext. Diese Felder liegen beieinander, sodass Sie die Sitzung als ein Ereignis lesen können, anstatt separate Seiten zusammenzufügen. Derselbe Anfragedatensatz ist im Dashboard verfügbar, was beim Vergleich der Konsolenansicht mit den Daten auf Kontoebene hilft. Der Leitfaden zur Request Console erklärt, wo sich diese Beweise befinden.
Wenn zum Beispiel das erste Token früh eintrifft und die Antwort sich hinzieht, ist ttft_ms nicht das Hauptsignal, da der Rest des Streams das Problem ist. Sie können den Routen- und Cache-Status im selben Anfragedatensatz einsehen. Sie können prüfen, ob die Anfrage einen Cache getroffen hat oder an das Modell ging. Sie können sehen, welcher Key- und Modellkontext angehängt war.
Nichts davon erzählt für sich allein die ganze Geschichte, aber zusammen geben sie Ihnen einen Anhaltspunkt. Wenn wir eine langsame Sitzung beobachten, enthält das Anfrageprotokoll die Details, die wir benötigen. Wir vergleichen ttft_ms mit den anderen Beweisen auf Anfrageebene, bevor wir eine Schlussfolgerung ziehen.
Derselbe Workflow hilft, wenn eine Anfrage aufgrund des Guthabens fehlschlägt oder pausiert. Der Anfragedatensatz enthält den Abrechnungsstatus, sodass der Fehler kein Rätsel ist. Der Auflade-Button befindet sich direkt neben der Konversation, sodass die Lösung im selben Fenster bleibt. Sie müssen die Sitzung nicht verlassen, um den nächsten Schritt zu finden, sodass Sie aufladen und dann fortfahren können.
Wenn das Guthaben in Ordnung ist, können Sie mit dem Routing, dem Cache-Status oder der Modellauswahl fortfahren. Der Punkt ist, die Beweise auf Anfrageebene in der richtigen Reihenfolge zu lesen. Fragen Sie zuerst, wann das erste Token eingetroffen ist, dann, welche Route es bedient hat, und dann, was der Datensatz sonst noch über Abrechnung, Cache, Modell und Key-Kontext aussagt. Diese Reihenfolge ist einfach und entspricht der Art und Weise, wie die Konsole die Daten präsentiert.
Einschränkungen
Streaming zeigt Fortschritt, nicht Durchsatz, da ein Stream schnell beginnen und dennoch lange dauern kann, bis er abgeschlossen ist. Ein schnelles erstes Token beweist nicht, dass die gesamte Anfrage schnell ist. Das Timing des ersten Tokens hängt auch vom Modell und der Route ab. Vergleichen Sie innerhalb eines Modells und nicht zwischen verschiedenen Modellen.
Eine Änderung in ttft_ms kann das Routing, den Cache-Status oder die Modellauswahl widerspiegeln, nicht nur den Prompt. Betrachten Sie ttft_ms als ein Signal im Anfrageprotokoll. Kombinieren Sie es mit den anderen Beweisen auf Anfrageebene, bevor Sie eine Schlussfolgerung ziehen. Dies ist eine Oberfläche zum Lesen einer Sitzung, kein Benchmark für das Ranking von Modellen.
Die Konsole macht aus einem Chat-Stream keinen Job-Runner. Wenn Sie eine lang laufende Bildaufgabe haben, verwenden Sie den Leitfaden für asynchrone Bildgenerierungsaufgaben, anstatt einen Chat-Stream offen zu halten. Die Streaming-Oberfläche ist für Antworten gedacht, die Token für Token eintreffen. Der asynchrone Leitfaden ist für Arbeiten gedacht, die außerhalb einer Chat-Antwort ausgeführt werden.
Denken Sie auch daran, dass Beweise auf Anfrageebene auf die Organisation beschränkt sind, was eine Anfrage mit dem Kontokontext verknüpft. Das bedeutet auch, dass Sie eine Anfrage nicht als globalen Benchmark behandeln sollten. Der Datensatz deckt Routing, Abrechnungsstatus, Cache-Status sowie Modell- und Key-Kontext für diese Anfrage ab. Es ist ein guter Ausgangspunkt für eine Diagnose. Es ist kein Ranking von Anbietern oder Modellen. Wenn wir Sitzungen vergleichen, vergleichen wir innerhalb desselben Modells und derselben Routenfamilie, was den Vergleich fair hält.
FAQ
Funktionieren meine alten Konsolen-Links noch?
Ja. Alte Links funktionieren weiterhin und bestehende Konversationen wurden bei der Zusammenführung beibehalten. Es muss nichts manuell migriert werden. Wenn Sie eine Konsolenseite als Lesezeichen gespeichert haben, funktioniert sie weiterhin.
Was misst das Timing des ersten Tokens eigentlich?
Es misst, wann das erste Token in einer Streaming-Antwort eintrifft. Die Konsole zeigt dies in der Oberfläche an und zeichnet es als ttft_ms auf, eine optionale Spalte im Anfrageprotokoll. Es misst nicht die Gesamtlatenz oder den Durchsatz.
Wo lade ich auf, wenn das Guthaben einer Konversation aufgebraucht ist?
Verwenden Sie den Auflade-Button neben der Konversation, der erscheint, wenn das Guthaben mitten in einer Konversation zur Neige geht, sodass Sie das Guthaben verwalten können, ohne die Sitzung zu verlassen. Die Abrechnungsseite im Dashboard bleibt der Ort für umfassendere Kontoarbeiten.
Kann ich das Timing des ersten Tokens über verschiedene Modelle hinweg vergleichen?
Nein, kein sauberer Vergleich. Das Timing des ersten Tokens hängt vom Modell und der Route ab. Vergleichen Sie daher innerhalb eines Modells und nicht zwischen verschiedenen Modellen. Verwenden Sie ttft_ms als ein Signal auf Anfrageebene, nicht als Modell-Ranking.
Erstellen Sie einen API-Key und führen Sie eine Sitzung in der neuen Konsole unter dem Dashboard aus.
Quellen
- TokenLab changelog: Console convergence and streamingGeprüft am 2026-09-19
- TokenLab dashboardGeprüft am 2026-09-19