TokenLab Consoleは、コーディングアシスタントモードとAIアプリケーションモードが1つの作業画面に統合されたことで、単なるダッシュボード以上の存在となりました。私たちのパイプラインでは、リクエスト、レスポンス、そしてそれらを取り巻くアカウントの状態が1か所に集約されています。これにより、セッションごとのコンテキスト切り替えが不要になり、レスポンスが遅い場合の読み解き方も変わりました。
重要なポイント
- コーディングアシスタントモードとAIアプリケーションモードは、どちらもTokenLab Console内で動作するようになり、従来の2つの入り口は統合されました。
- 既存のリンクはそのまま機能し、これまでの会話履歴もすべて保持されています。手動での移行作業は一切不要です。
- レスポンスは終了まで待つのではなく、モデルの生成に合わせてストリーミング表示されます。インターフェースには最初のトークンが表示されるまでの時間が表示されます。
- 最初のトークンまでのレイテンシ(First-token latency)は、インターフェース上の装飾ではなく、リクエストログに記録されるリクエスト信号(
ttft_ms)として扱われます。 - 会話の途中で残高が不足した場合、別の請求ページに移動することなく、会話のすぐ横からチャージが可能です。
- コンソールのモデル選択は公開カタログに準拠しています。最新のオプションについてはモデルディレクトリをご確認ください。現在のカタログ例には、Claude Sonnet 5やDeepSeek V4 Proなどがあります。
TokenLab Consoleの変更点と維持された点
この変更は、2つのチェンジログエントリとしてリリースされました。コンソールの統合(2026-08-04)により、2つの古い入り口が1つのコンソールにまとめられました。コンソールチャットのストリーミング(2026-08-18)により、チャットにストリーミング機能が追加されました。この2つの変更は1か月間隔で実施されたため、最初の変更を見逃したチームでも、後者の変更を自動的に享受できます。
これは表面的な変更であり、動作上の変更ではありません。モデルの呼び出し、キー、請求体系に変更はありません。古いリンクは引き続き機能し、既存の会話も統合を通じて保持されています。手動での移行ステップはありません。
統合ステップは入り口に関するものであり、モデルへのアクセスに関するものではありません。ストリーミングステップはレスポンスの表示方法に関するものであり、どのトークンが課金されるかという点に変更はありません。製品の表面的な変更が動作上の変更を隠してしまうことがありますが、今回はそうではありません。コーディングアシスタントモードとAIアプリケーションモードが1つの場所に統合されたため、セッション開始時にどちらの入り口を開くか迷う必要はなくなりました。
チームのランブック(手順書)に古い入り口へのリンクがある場合は、可能なタイミングでラベルを更新してください。古いリンクも引き続き解決されるため、ランブックが壊れることはありません。新しい作業については、コンソールをブックマークすることをお勧めします。どちらのモードでもモデルを選択する際は、公開カタログに従うため、モデルディレクトリを確認してください。現在のカタログ例には、Claude Sonnet 5やDeepSeek V4 Proなどがあります。
TokenLab Consoleのストリーミングによるセッションの読み解き方の変化
ストリーミングにより、何かが起きていることを即座に把握できるようになりました。私たちのパイプラインでは、コンソールゲートウェイクライアントがストリーミングチャットリクエストを構築し、レスポンスが段階的にレンダリングされます。インターフェースには最初のトークンまでの時間が表示されるため、モデルがいつ回答を開始したかを確認できます。コンソールは、この信号をリクエストログのオプション列であるttft_msとして記録します。
最初のトークンまでの時間は最初のトークンが到着したタイミングを示し、合計レイテンシはレスポンス全体が完了したタイミングを示します。これらは異なる問いであるため、レスポンスが遅いと感じた場合は、まずttft_msを確認してください。最初のトークンが遅い場合は生成前の待機時間が長く、最初のトークンが早く、その後のレスポンスが停滞している場合は、ストリームの残りの部分に問題があることを示しています。
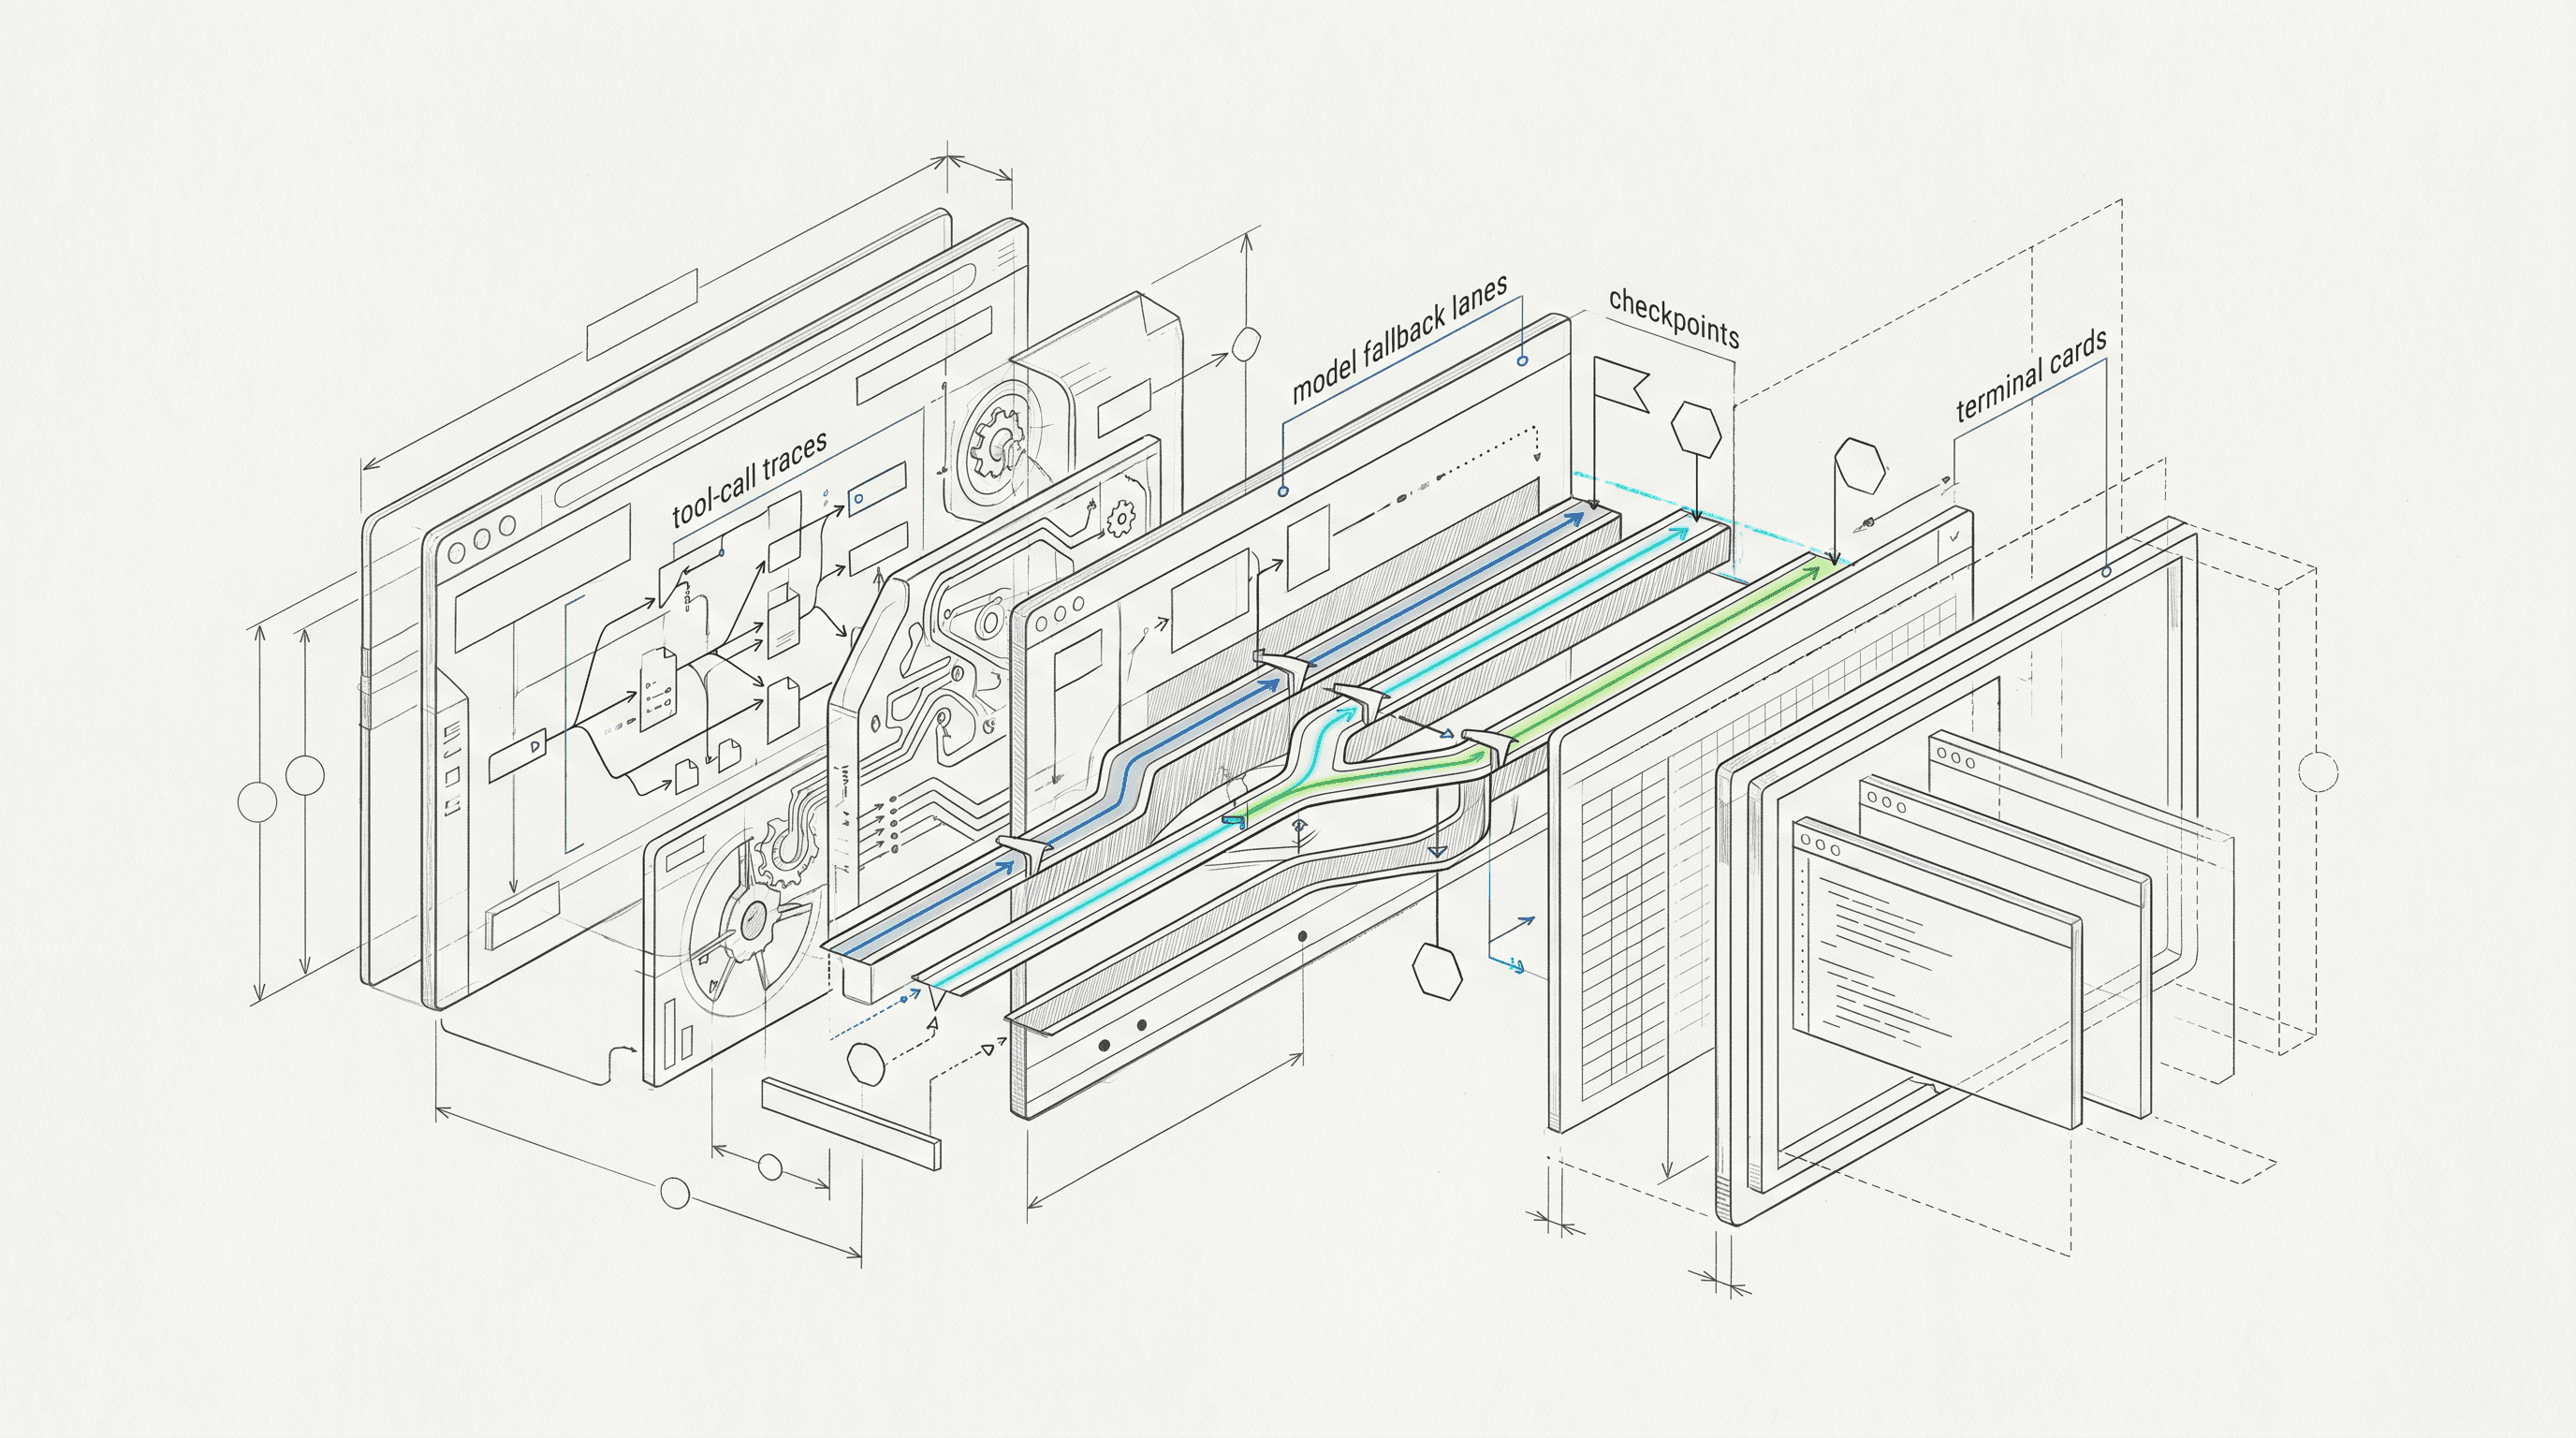
遅いセッションを監視する際、私たちはスピナー(読み込みアイコン)から推測するのではなく、ttft_msと他のリクエスト証跡を比較します。リクエストレベルの証跡は組織単位でスコープされており、ルーティング、請求状態、キャッシュ状態、そしてリクエストの背後にあるモデルとキーのコンテキストを網羅しています。コンソールは、本来ならログから掘り起こさなければならないリクエストレコードをそのまま表示します。
最初のトークン信号を読み解く例:
# コンソールのリクエストログは、オプション列として `ttft_ms` を公開しています。
# 1. リクエストログをフィルタリングして、確認したいリクエストを特定します。
# 2. `ttft_ms` を読み取ります。
# 3. 同じ行にあるリクエストの合計レイテンシと `ttft_ms` を比較します。
正確なストリーミングリクエストの形式については、最新のTokenLab APIドキュメントを参照してください。架空のフィールドを含むコピーされたリクエスト例よりも、その名称を定義しているドキュメントページの方が有用です。
ストリーミングによって課金対象が変わることはありません。生成されるトークンは同じですが、到着するたびに可視化されるだけです。レスポンスがストリーミングされるようになったため、セッションが中断されても何も表示されないのではなく、途中までのレスポンスが表示されます。これにより、セッション途中の障害診断方法が変わります。チャットストリームでカバーできない長時間実行ジョブについては、非同期画像生成タスクガイドを参照してください。
推測せずに遅いセッションを検証する方法
スピナーではなく、リクエストログから始めてください。ttft_ms列が最初のトークンの到着時間を教えてくれるからです。その数値が高い場合、モデルはまだ回答を開始していませんでした。数値が低い場合、モデルは早期に開始しましたが、残りのストリームに時間がかかりました。この切り分けにより、パスの誤った部分を責めることを防げます。
リクエストレコードは組織単位でスコープされています。これには、リクエストを処理したルート、請求状態、キャッシュ状態、モデルおよびキーのコンテキストが含まれます。これらのフィールドは1か所にまとめられているため、別々のページをつなぎ合わせるのではなく、1つのイベントとしてセッションを読み解くことができます。同じリクエストレコードはダッシュボードでも利用可能であり、コンソールの表示とアカウントレベルのデータを比較する際に役立ちます。Request Consoleガイドで、その証跡がどこにあるかを解説しています。
例えば、最初のトークンが早く、レスポンスが停滞している場合、ttft_msは主要な信号ではありません。残りのストリームが原因だからです。同じリクエストレコード内でルートとキャッシュ状態を確認できます。リクエストがキャッシュにヒットしたのか、モデルに送信されたのかを確認できます。どのキーとモデルコンテキストが使用されたかも確認できます。
これら単体では全体像は分かりませんが、組み合わせることで確認すべき場所が明確になります。遅いセッションを監視する際、リクエストログには必要な詳細がすべて含まれています。結論を出す前に、ttft_msと他のリクエストレベルの証跡を比較します。
同じワークフローは、残高不足でリクエストが失敗または一時停止した場合にも役立ちます。リクエストレコードには請求状態が含まれているため、失敗の原因は不明ではありません。チャージ用の入り口は会話のすぐ横にあるため、修正作業も同じウィンドウ内で完結します。次のステップを探すためにセッションを離れる必要はなく、チャージしてそのまま継続できます。
残高に問題がない場合は、ルーティング、キャッシュ状態、またはモデル選択へと進むことができます。重要なのは、リクエストレベルの証跡を順序立てて読み解くことです。まず最初のトークンがいつ到着したかを問い、次にどのルートがそれを処理したかを問い、最後に請求、キャッシュ、モデル、キーコンテキストについてレコードが何を語っているかを問います。この順序はシンプルであり、コンソールがデータを提示する方法と一致しています。
制限事項
ストリーミングは進捗を示すものであり、スループットを示すものではありません。ストリームは素早く開始しても、完了までに時間がかかる可能性があるためです。最初のトークンが速いからといって、リクエスト全体が速いとは限りません。最初のトークンまでの時間はモデルやルートにも依存します。モデル間ではなく、モデル内で比較してください。
ttft_msの変化は、プロンプトだけでなく、ルーティング、キャッシュ状態、モデル選択を反映している可能性があります。ttft_msはリクエストログ内の1つの信号として扱ってください。結論を出す前に、他のリクエストレベルの証跡と組み合わせてください。これはセッションを読み解くためのインターフェースであり、モデルをランク付けするためのベンチマークではありません。
コンソールはチャットストリームをジョブランナーに変えるものではありません。長時間実行される画像タスクがある場合は、チャットストリームを開いたままにするのではなく、非同期画像生成タスクガイドを使用してください。ストリーミングインターフェースは、トークンごとに到着するレスポンスのためのものです。非同期ガイドは、チャットレスポンスの外で実行される作業のためのものです。
また、リクエストレベルの証跡は組織単位でスコープされており、リクエストをそれを取り巻くアカウントコンテキストに結び付けていることを忘れないでください。これは、1つのリクエストをグローバルなベンチマークとして扱ってはならないことも意味します。レコードは、そのリクエストのルーティング、請求状態、キャッシュ状態、モデルおよびキーコンテキストをカバーしています。診断を開始するには最適な場所ですが、プロバイダーやモデルのランキングではありません。セッションを比較する際は、同じモデルかつ同じルートファミリー内で比較することで、公平な比較を維持できます。
FAQ
古いコンソールのリンクはまだ使えますか?
はい。古いリンクは引き続き機能し、既存の会話も統合を通じて保持されています。手動での移行作業は一切不要です。コンソールのページをブックマークしている場合、そのまま解決されます。
最初のトークンまでの時間は実際に何を測定していますか?
ストリーミングレスポンスにおいて最初のトークンが到着するまでの時間を測定します。コンソールはこれをインターフェース上に表示し、リクエストログのオプション列であるttft_msとして記録します。合計レイテンシやスループットを測定するものではありません。
会話の途中で残高が不足した場合、どこでチャージすればよいですか?
会話の途中で残高が不足した際に表示される、会話のすぐ横にあるチャージ用入り口を使用してください。セッションを離れることなく残高を管理できます。ダッシュボードの請求ページは、より広範なアカウント管理のための場所として残っています。
異なるモデル間で最初のトークンまでの時間を比較できますか?
いいえ、純粋な比較はできません。最初のトークンまでの時間はモデルとルートに依存するため、モデル間ではなくモデル内で比較してください。ttft_msはモデルのランキングではなく、リクエストレベルの信号として使用してください。
APIキーを作成し、ダッシュボードの新しいコンソールでセッションを実行してみてください。
出典
- TokenLab changelog: Console convergence and streaming2026-09-19 時点で確認
- TokenLab dashboard2026-09-19 時点で確認